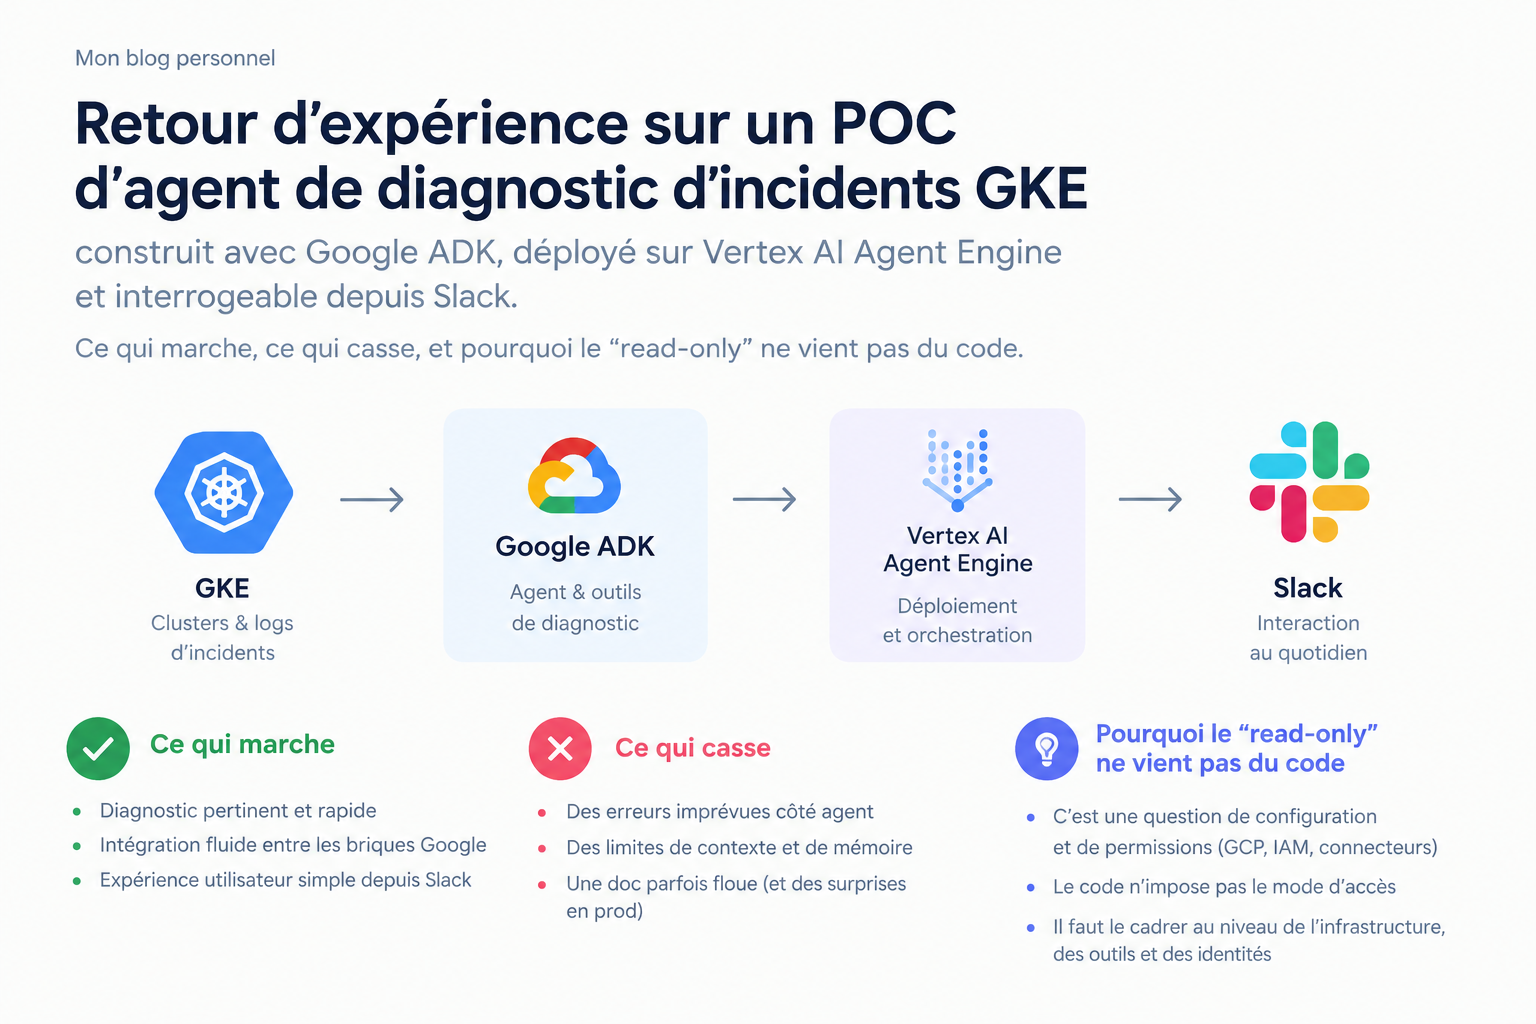
Quand une alerte tombe sur un cluster GKE, la première demi-heure ressemble toujours à la même chose : ouvrir Cloud Monitoring, sauter dans Cloud Logging, chercher les events Kubernetes du namespace, se demander si quelqu’un n’aurait pas déployé quelque chose juste avant. C’est mécanique, c’est chronophage, et ça pèse directement sur le MTTR, l’une des quatre métriques DORA.
J’ai voulu voir ce qu’un agent pouvait faire de cette corrélation. Le POC s’appelle sre_agent : un copilote de diagnostic construit avec l’Agent Development Kit de Google, déployé sur Vertex AI Agent Engine, et interrogeable depuis Slack. Il lit les alertes, les logs, les events et les déploiements récents, puis propose une cause probable, une timeline et un brouillon de postmortem.
Cet article est le retour d’expérience de cette construction. Moins le tutoriel “comment faire un agent”, plus la liste des endroits où ça m’a mordu les doigts.
L’architecture en une image
Trois briques, déployées séparément :
- L’agent ADK (
sre_agent/) : une définition d’agent, un modèle Gemini, quatre tools en lecture seule. Testable en local avecadk web, déployable sur Agent Engine avec une seule commande. - Les tools (
sre_agent/tools.py) : du Python qui interroge les APIs GCP et renvoie des dictionnaires. C’est là que se joue 90% de la qualité du diagnostic. - Le bot Slack (
slack_bot/) : un petit service Flask sur Cloud Run qui relaie les mentions vers l’agent et reposte la réponse dans le thread.
Les quatre tools
Le contrat est simple : l’agent diagnostique, il n’agit jamais. Aucun tool ne modifie l’état du cluster, ne déclenche un déploiement ou n’écrit dans un système externe.
| Tool | Source | Ce qu’il répond |
|---|---|---|
get_alerts(time_range) | Cloud Monitoring | Les alert policies configurées sur le projet |
get_pod_logs(namespace, pod) | Cloud Logging | Les dernières lignes de log d’un conteneur |
get_k8s_events(namespace) | Cloud Logging | Les events Kubernetes récents du namespace |
get_recent_deploys(namespace) | Cloud Audit Logs | Les déploiements récents, pour la corrélation déploiement → incident |
Le dernier est celui qui apporte le plus de valeur en pratique : c’est la question “est-ce qu’on a poussé quelque chose juste avant ?” qui résout la majorité des incidents. Les Admin Activity audit logs (cloudaudit.googleapis.com/activity) tracent les créations et mises à jour de Deployment, avec le principal qui les a faites.
Ce qui a cassé, et pourquoi c’est intéressant
get_alerts ne fait pas ce que son nom promet
Premier piège, et le plus sournois. L’API Cloud Monitoring n’expose pas publiquement les incidents ouverts, c’est à dire les alertes qui sonnent en ce moment. Elle n’expose que leur configuration.
Résultat : mon tool s’appelait get_alerts, renvoyait une clé alerts, et l’agent lisait ça comme “voilà ce qui est en train de sonner”. Il présentait fièrement une policy “High CPU utilization” comme le symptôme d’un incident, alors que c’était juste une règle configurée sur un projet parfaitement sain.
Le correctif ne tient pas dans le code, il tient dans le vocabulaire rendu au modèle :
return {
    "time_range": time_range,
    "note": (
        "Alert policies configured on the project, not alerts currently"
        " firing (the Cloud Monitoring API does not expose open incidents)."
    ),
    "alert_policies": alert_policies,
}
La clé s’appelle désormais alert_policies, pas alerts, et la note fait partie de la réponse, pas d’un commentaire. L’instruction de l’agent le répète une troisième fois : “that tool cannot tell you which alerts are firing, treat its output as what the project monitors and never present a policy as an active alert”.
Leçon retenue : pour un agent, le nom d’une clé de dictionnaire est une instruction. Un champ mal nommé se transforme en hallucination, sans qu’aucune ligne de code ne soit fausse.
La fenêtre temporelle figée au démarrage
Tous les tools qui interrogent Cloud Logging filtrent sur timestamp>= une heure glissante. J’avais écrit ça proprement, en constante de module :
since = (datetime.now(UTC) - timedelta(hours=1)).strftime(time_format)
Sauf qu’un agent est un processus long-lived. En local avec adk web, sur Agent Engine encore plus. La constante gèle la fenêtre à l’heure précédant le démarrage du processus. Au bout de deux heures d’uptime, l’agent rapporte un namespace en feu comme parfaitement calme, puisqu’il ne regarde plus que du passé.
C’est devenu une fonction appelée à chaque requête :
def _since(hours: int = 1) -> str:
    return (datetime.now(UTC) - timedelta(hours=hours)).strftime(time_format)
Un bug trivial, invisible en test unitaire, et qui rend l’agent silencieusement inutile après une heure.
methodName:"deployments" matche aussi les suppressions
Dans get_recent_deploys, l’opérateur : de Cloud Logging fait du “contains”. Un filtre protoPayload.methodName:"deployments" attrape donc ...deployments.delete au passage. Une suppression de Deployment se retrouvait listée comme un déploiement, et l’agent la corrélait joyeusement avec l’incident comme si c’était une mise en production.
Il a fallu écrire les trois méthodes en toutes lettres :
f' AND (protoPayload.methodName:"deployments.create"'
f' OR protoPayload.methodName:"deployments.update"'
f' OR protoPayload.methodName:"deployments.patch")'
L’injection dans les filtres Cloud Logging
Celui là mérite qu’on s’y arrête. Les arguments namespace et pod sont choisis par le modèle, donc in fine par la personne qui parle à l’agent, et ils sont interpolés dans une chaîne de filtre Cloud Logging. Un guillemet ou une parenthèse dans l’un d’eux ne se contente pas de ne rien matcher : il change le sens du filtre.
C’est exactement le même problème qu’une injection SQL, avec un vecteur différent : le paramètre ne vient pas d’un formulaire, il vient d’un LLM.
Le read-only ne vient pas du code, il vient de l’IAM
C’est le point que je retiens le plus de ce POC.
J’ai écrit en gros dans le CLAUDE.md du projet que tous les tools sont en lecture seule. C’est vrai. Ça ne garantit rien.
Ce qui rend l’agent réellement incapable d’agir sur le cluster, c’est l’identité sous laquelle il tourne. Les tools n’interrogent que Cloud Logging et Cloud Monitoring, donc deux rôles suffisent :
AGENT_SA=<le service account affiché sur l'instance Agent Engine>
for role in roles/logging.viewer roles/monitoring.viewer; do
  gcloud projects add-iam-policy-binding <project-id> \
    --member "serviceAccount:${AGENT_SA}" --role "$role" --condition=None
done
Ces deux là, et rien d’autre. Si le service account de l’agent garde un rôle Editor, la garantie “read-only” ne repose plus que sur la discipline du code. Et il y a deux façons de la perdre : un tool ajouté plus tard qui fait un kubectl apply, ou une prompt injection glissée dans une ligne de log que l’agent lit. Un agent qui ingère des logs ingère du texte écrit par des tiers. Si son identité peut écrire, ce texte peut le faire écrire.
Même raisonnement côté bot Slack. Le compte de service par défaut de Cloud Run (<project-number>-compute@developer.gserviceaccount.com) porte le rôle Editor sur tout le projet. Un bot qui n’a besoin que d’interroger l’agent et de lire deux secrets pourrait donc supprimer un workload GKE. Le script de déploiement lui crée son propre service account avec roles/secretmanager.secretAccessor sur les deux secrets et roles/aiplatform.user sur le projet, point.
💡 La garantie de sécurité d’un agent ne s’écrit pas dans son prompt ni dans ses fonctions. Elle s’écrit dans sa policy IAM.
Le déploiement sur Agent Engine
Vertex AI Agent Engine est un hébergement managé et serverless pour agents ADK. Le déploiement tient en une commande :
uv run adk deploy agent_engine sre_agent \
  --project=<project-id> \
  --region=<region> \
  --display_name="SRE Agent"
Trois choses à savoir avant de la lancer :
Le CLI devient muet. Après la ligne “Dockerfile created at …”, plus rien. Le build et le déploiement se passent côté serveur, ça prend 5 à 15 minutes sur un premier déploiement, et la CLI n’affiche rien entre temps. On croit à un blocage, ça n’en est pas un.
Les dépendances runtime ne sont pas déduites du pyproject.toml. Il faut un sre_agent/requirements.txt qui liste explicitement ce dont les tools ont besoin (google-cloud-monitoring, google-cloud-logging, google-api-core, google-auth). S’il désynchronise du pyproject.toml, le conteneur déployé plante à l’import, pas au build.
GOOGLE_CLOUD_PROJECT n’est pas transmis. adk deploy agent_engine utilise cette variable uniquement pour choisir la cible de déploiement, il ne la propage pas comme variable d’environnement à l’agent déployé. Les tools se retrouvent donc sans projet. Le contournement consiste à retomber sur le projet découvert via les Application Default Credentials :
Ça marche en local (ADC de l’utilisateur) comme sur Agent Engine (identité du service account).
L’interface Slack
Interroger l’agent depuis adk web c’est bien pour développer, mais un copilote d’incident doit vivre là où l’incident se discute. slack_bot/app.py est un service Flask qui reçoit les callbacks de l’Events API Slack (app_mention), relaie le message à l’agent déployé, et reposte la réponse dans le même thread.
Slack ne rend pas le Markdown
Un brouillon de postmortem, c’est des titres, des tableaux, des listes. Slack n’en rend rien dans un message ordinaire : on obtient un pavé de dièses et d’astérisques (la capture de la V2 plus bas montre exactement ça).
La solution passe par un contrat explicite entre l’agent et le bot : l’agent est instruit d’émettre une ligne séparatrice contenant exactement ===DRAFT POSTMORTEM===, le bot coupe dessus, poste le résumé court en message et uploade le postmortem en fichier .md dans le thread.
Le marqueur est dupliqué des deux côtés (dans l’instruction de l’agent et dans le bot) parce que les deux composants sont déployés séparément, sur Agent Engine et sur Cloud Run, sans module partagé. C’est une dette assumée, notée en commentaire aux deux endroits.
Scale-to-zero et contrainte de correction
Le service tourne avec --min-instances=0 : sans trafic, pas de conteneur, donc coût quasi nul entre deux mentions. Classique et sans conséquence.
--max-instances=1 en revanche n’est pas une contrainte de coût, c’en est une de correction. Le bot garde en mémoire la correspondance thread Slack → session Agent Engine, pour qu’un thread conserve son contexte conversationnel :
Corollaire du scale-to-zero : un thread rementionné après une période d’inactivité repart sur une session vierge. Acceptable pour un POC, pour aller plus loin il vaut mieux se tourner vers un store partagé (Firestore, Redis).
Ce que ça donne, et ce qui reste
Pour vérifier que l’agent identifie une vraie cause et ne se contente pas de produire un texte plausible, j’ai cassé volontairement le déploiement dummy-app du namespace toto : une directive inexistante glissée dans la configuration NGINX, de quoi mettre le pod en crashloop.
La V1 dans ADK (local)
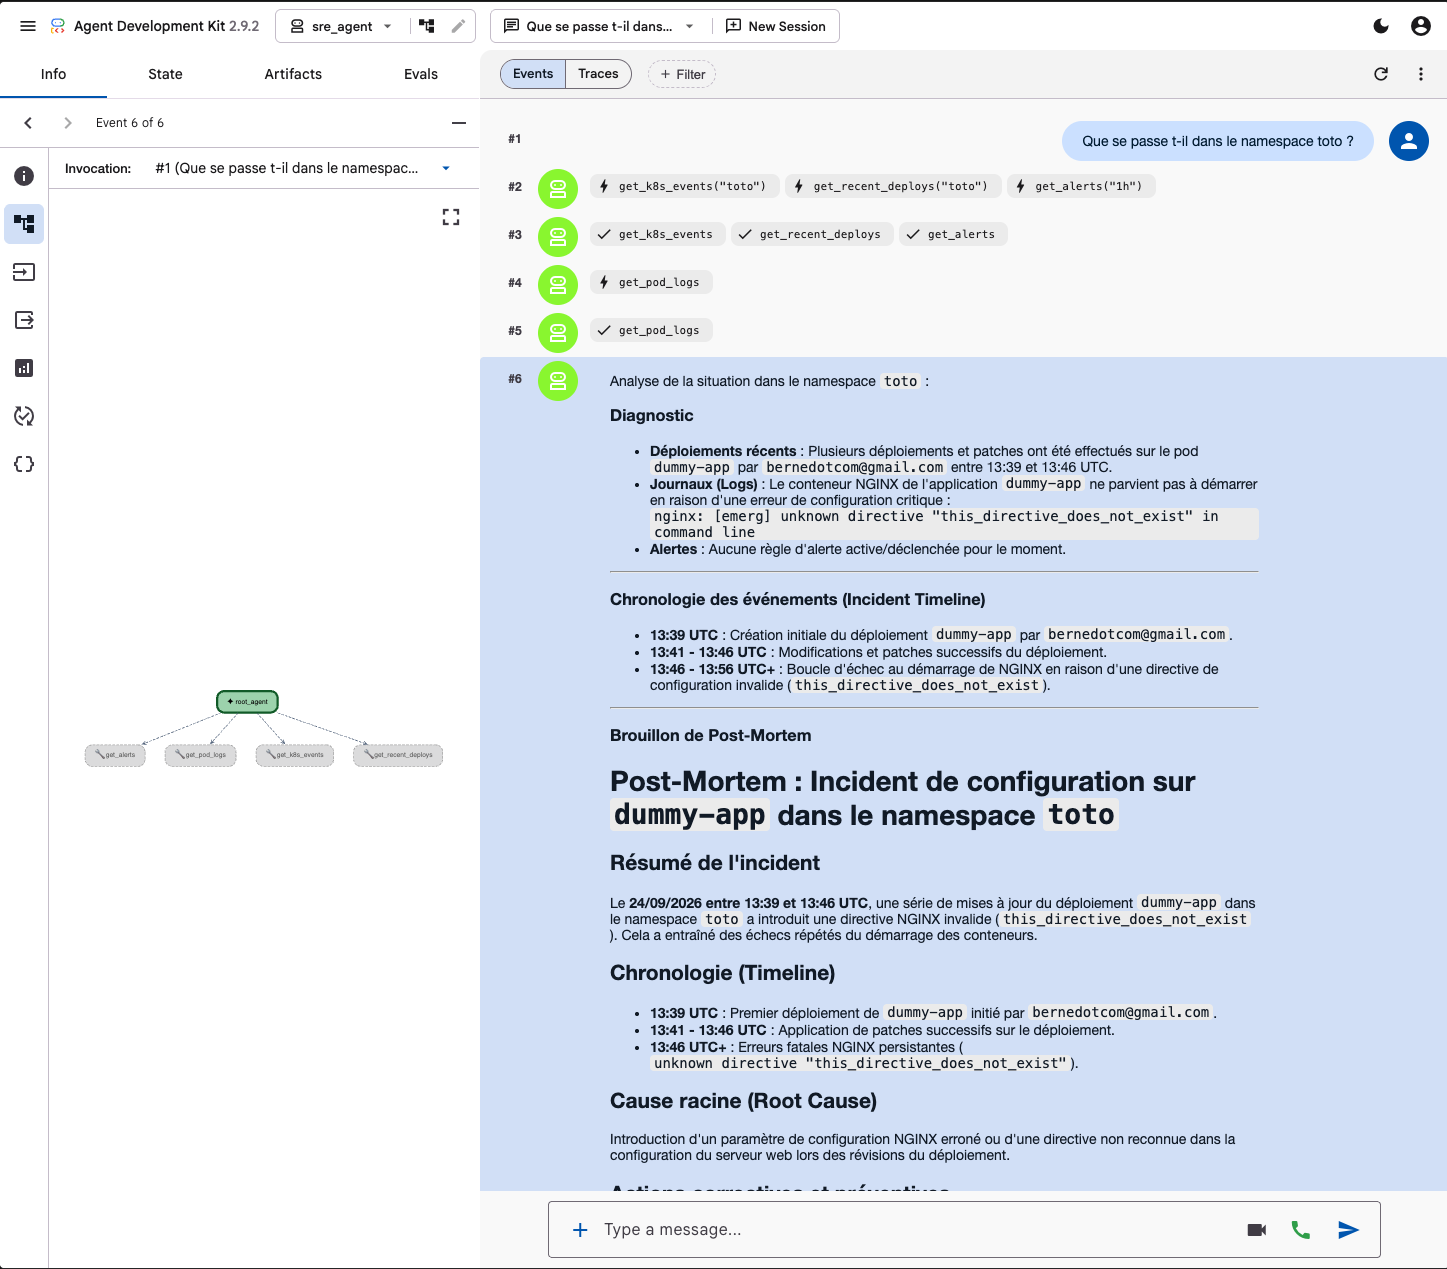
Sur un simple “Que se passe t-il dans le namespace toto ?”, l’agent enchaîne get_k8s_events, get_recent_deploys et get_alerts en parallèle, puis appelle get_pod_logs sur le pod qu’il vient de repérer dans les events. Il remonte la bonne cause (nginx: [emerg] unknown directive "this_directive_does_not_exist"), la corrèle avec la série de patches appliqués au déploiement entre 13h39 et 13h46, reconstruit la timeline et produit le brouillon de postmortem.
Le détail qui compte : sur les alertes, il répond “aucune règle déclenchée”. C’est la bonne réponse, et c’est précisément la confusion avec les policies configurées qu’il faisait avant le correctif décrit plus haut.
La V2 (Slack)
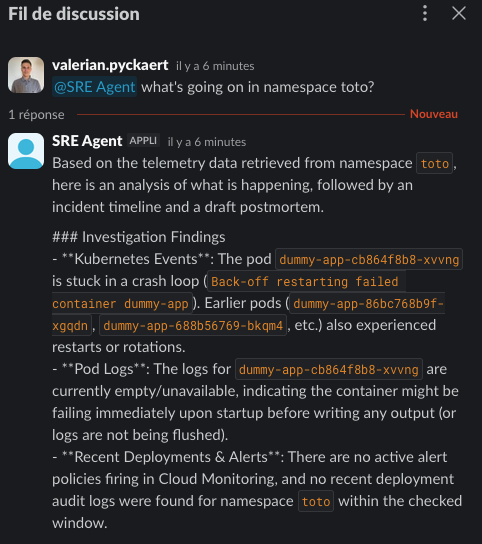
Même diagnostic, cette fois via une mention dans un canal. On y voit aussi le problème de rendu Markdown en vrai : les ### et les ** arrivent bruts dans le message, ce qui a motivé le découpage sur ===DRAFT POSTMORTEM=== et l’upload du postmortem en fichier.
L’instruction interdit explicitement à l’agent d’inventer : “Every symptom you state must come from a tool result; if the tools show nothing wrong, say so instead of inferring an incident from the configured alert policies.”
Ce qui reste
- Mesurer. Temps de diagnostic agent contre diagnostic manuel, pertinence de la cause identifiée. Sans chiffre, l’argument MTTR reste une intention.
- Élargir les scénarios. Le crashloop de configuration est le cas facile : la cause est écrite en toutes lettres dans les logs. Reste à voir ce que ça donne sur une saturation mémoire, une dépendance externe lente, ou une panne qui ne laisse pas de trace explicite.
- Persister les sessions hors mémoire pour lever le
max-instances=1.
Ce que je retiens
Construire l’agent a pris quelques heures. Le rendre fiable a pris tout le reste, et les corrections n’ont presque jamais porté sur le modèle ou le prompt.
Les bugs qui comptaient étaient des bugs d’ingénieur classiques : une constante calculée trop tôt, un filtre qui matche trop large, un paramètre non validé avant interpolation, un mauvais compte de service. La différence, c’est leur mode de défaillance. Un filtre Cloud Logging trop large ne renvoie pas une erreur, il renvoie des données que le modèle intègre avec assurance dans un diagnostic. Le système ne casse pas, il ment.
D’où la vraie leçon du POC : sur un agent, la surface de qualité n’est pas le prompt, c’est la frontière entre les tools et le monde réel. Le nom des clés qu’on renvoie, la précision des filtres, la validation des entrées, et surtout les permissions IAM de l’identité qui exécute tout ça. Le prompt, lui, ne fait que raconter ce que les tools lui donnent.
Lien vers le repository du poc.